Hindsight: 에이전트 기억을 저장하고 찾고 활용하기
에이전트가 세션 너머로 배우도록 기억을 구조화한 오픈소스 기억 시스템. 네 기억 종류와 저장·검색·추론, RAG와의 분업, 미실행 따라가기 세 장면과 이웃 기술 나란히 보기, 개념도·원문 그림으로 정리했다.
고친 내용: 연락처 따라가기를 3월·4월 독립 문서 흐름으로 고치고, 이웃 기술 나란히 보기의 Mem0 Platform·OSS 구분과 Graphiti 검색 결과 종류를 바로잡고, 네 기억 종류 표현과 삽화 설명·출처 표기를 다듬었다. RAG 기준선 주의문은 그대로 둔다.
Hindsight란 무엇인가
Hindsight는 AI 에이전트가 대화가 끝난 뒤에도 기억을 이어가도록 만든 오픈소스 장기 기억 시스템이다. Vectorize가 MIT 허가서로 공개했으며, 대표 논문은 2026년 7월 전산언어학회(ACL) 시스템 데모 부문에 실렸고, 그 전에 2025년 12월 14일 arXiv 사전 공개판이 먼저 나왔다. 문서는 그 뒤로 바뀌었을 수 있으니, 실행 전에는 반드시 최신 공식 문서를 다시 확인한다.
핵심 주장은 기억을 추론의 1급 재료로 취급하자는 것이다. 기억을 처음부터 구조화된 형태로 쌓고, 객관적 사실과 주관적 믿음을 나눠 둔다. 그래서 개발자는 에이전트가 무엇을 아는지와 무엇을 믿는지를 따로 들여다볼 수 있다. 이 글의 해석으로, 목표는 오래 기억하는 것 자체가 아니라 근거와 추론의 경계가 드러나는 기억이다.
기억은 문서 0.10 개요 기준으로 네 종류에 나눠 둔다. 세계 사실(World Fact)은 세상에 대한 객관적 사실을, 경험 사실(Experience Fact)은 에이전트가 겪은 일을, 관찰(Observation)은 개체별로 종합한 요약을, 멘탈 모델(Mental Model)은 자주 쓰는 지식을 다듬어 둔 것이다. 관찰과 멘탈 모델은 네 칸 안에 든 종류이지, 네 칸 밖에 덧댄 층이 아니다. 논문 쪽 표현 opinion(변하는 믿음)은 옛 이름이므로, 지금의 네 칸과 같은 층이라고 묶어 부르지 않는다. 기억을 한 통에 섞지 않고 쓰임새별로 나눠, 답의 근거를 물을 때 출처를 추적할 수 있게 한다는 것이 요지다.
| 기억 종류(문서 0.10 이름) | 무엇을 담는가 | 언제 읽는가 |
|---|---|---|
| 세계 사실 World Fact | 밖에서 들여온 객관적 사실 | 답의 근거 사실을 찾을 때 |
| 경험 사실 Experience Fact | 뱅크 자신의 행동·대응 기록 | 에이전트가 무엇을 했는지 물을 때 |
| 관찰 Observation | 사실을 묶어 다듬은 종합·믿음 | 개체별 최신 이해를 찾을 때 |
| 멘탈 모델 Mental Model | 자주 묻는 것을 다듬어 둔 정리 | 낯익은 답부터 찾을 때(위층 우선) |
표를 글로 읽기
네 행 비교표. 네 종류가 모두 행으로 든다. 세계 사실 World Fact는 밖에서 들여온 객관적 사실로 답의 근거를 찾을 때 읽는다. 경험 사실 Experience Fact는 뱅크 자신의 행동 기록으로 에이전트가 무엇을 했는지 물을 때 읽는다. 관찰 Observation은 사실을 묶어 다듬은 종합 믿음으로 개체별 최신 이해를 찾을 때 읽는다. 멘탈 모델 Mental Model은 자주 묻는 정리를 다듬어 둔 것으로 낯익은 답부터 찾을 때 읽는다. 관찰과 멘탈 모델은 네 종류 안에 든다.
언제 Hindsight를 쓰는가
잘 맞는 쓰임은 기억이 쌓이고 진화해야 하는 일이다. 대화를 넘어 상대를 기억해야 하는 비서, 누가 무엇을 맡았는지 따라가야 하는 협업 도우미, 지난 분기나 작년 같은 시간 질의가 잦은 기록 도우미, 답의 결이 흔들리면 안 되는 응대 창구가 예다. 이 용도 구분은 공식 비교 페이지의 권장을 옮긴 것이다.
반대로 자료가 고정되고 시간 조건이 없으면 검색 증강 생성 쪽이 간결할 수 있다. 정적 말뭉치에 대한 문서 질의응답이 예다. Hindsight를 들이면 서버와 데이터베이스, 거대언어모델 키의 운영비를 함께 들이게 되므로, 기억이 필요 없는 질의까지 기억 시스템으로 풀 필요는 없다. 무엇을 쓸지는 자료가 정적인지, 시간이 중요한지, 상대에 대한 이해가 쌓여야 하는지에 따라 가른다는 것이 이 글의 정리다.
RAG와의 관계: 대체가 아니라 분업
공식 비교 페이지는 Hindsight를 단순화된 의미 유사도 검색 중심의 RAG 기준선과 견준다. 이 대조는 모든 RAG가 그렇다는 뜻이 아니다. 실제 RAG 시스템도 혼합 검색, 그래프, 시간 거르기, 여러 단계 추론을 갖출 수 있다. 비교표는 특정 기준선에 대한 제작사의 설명으로만 읽는다.
페이지가 그리는 용도 구분은 분명하다. 변하지 않는 말뭉치에 대한 문서 질의응답이나 시간 조건이 없는 검색에는 RAG 쪽을, 여러 세션에 걸친 비서의 지속 기억과 개체 추적, 일관된 성향, 시간 질의에는 Hindsight 쪽을 권한다. 검색 전략·여러 단계 추론·시간 질의·개체 이해·지식 종합·성향의 여섯 갈래에서 차이를 설명한다.
이 글의 해석은 그래서 분업이다. 근거 문서를 읽고 답하는 일은 RAG의 강점이고, 시간을 넘나들며 상대를 알아가고 믿음을 다듬는 일은 기억 시스템의 강점이다. Hindsight는 RAG를 보완하는 이웃 기술이지, 모든 검색을 갈아치우는 보편 대체품이 아니다.
| 갈래 | RAG 기준선(제작사 설정) | Hindsight(제작사 설명) |
|---|---|---|
| 검색 전략 | 의미 유사도 중심 | 의미·키워드·그래프·시간 |
| 여러 단계 추론 | 가져온 조각 안에서만 | 개체 관계 따라 그래프 이동 |
| 시간 질의 | 계절어 낱말 맞추기 수준 | 날짜 풀이·범위 거르기 |
| 개체 이해 | 따로 두지 않음 | 개체 해소·동시 출현 추적 |
| 지식 종합 | 질의 사이 상태 없음 | 멘탈 모델로 다듬어 진화 |
| 성향 | 따로 두지 않음 | 세 기질(회의·직설·공감)이 해석에 반영 |
표를 글로 읽기
여섯 행 비교표. 검색 전략: 기준선은 의미 유사도 중심, Hindsight는 의미·키워드·그래프·시간. 여러 단계 추론: 기준선은 가져온 조각 안에서만, Hindsight는 개체 관계를 따라 그래프로 이동. 시간 질의: 기준선은 계절어 낱말 맞추기 수준, Hindsight는 날짜 풀이와 범위 거르기. 개체 이해: 기준선은 따로 두지 않음, Hindsight는 개체 해소와 동시 출현 추적. 지식 종합: 기준선은 질의 사이 상태 없음, Hindsight는 멘탈 모델로 다듬어 진화. 성향: 기준선은 따로 두지 않음, Hindsight는 세 기질이 해석에 반영.
핵심 동작: 저장·검색·추론
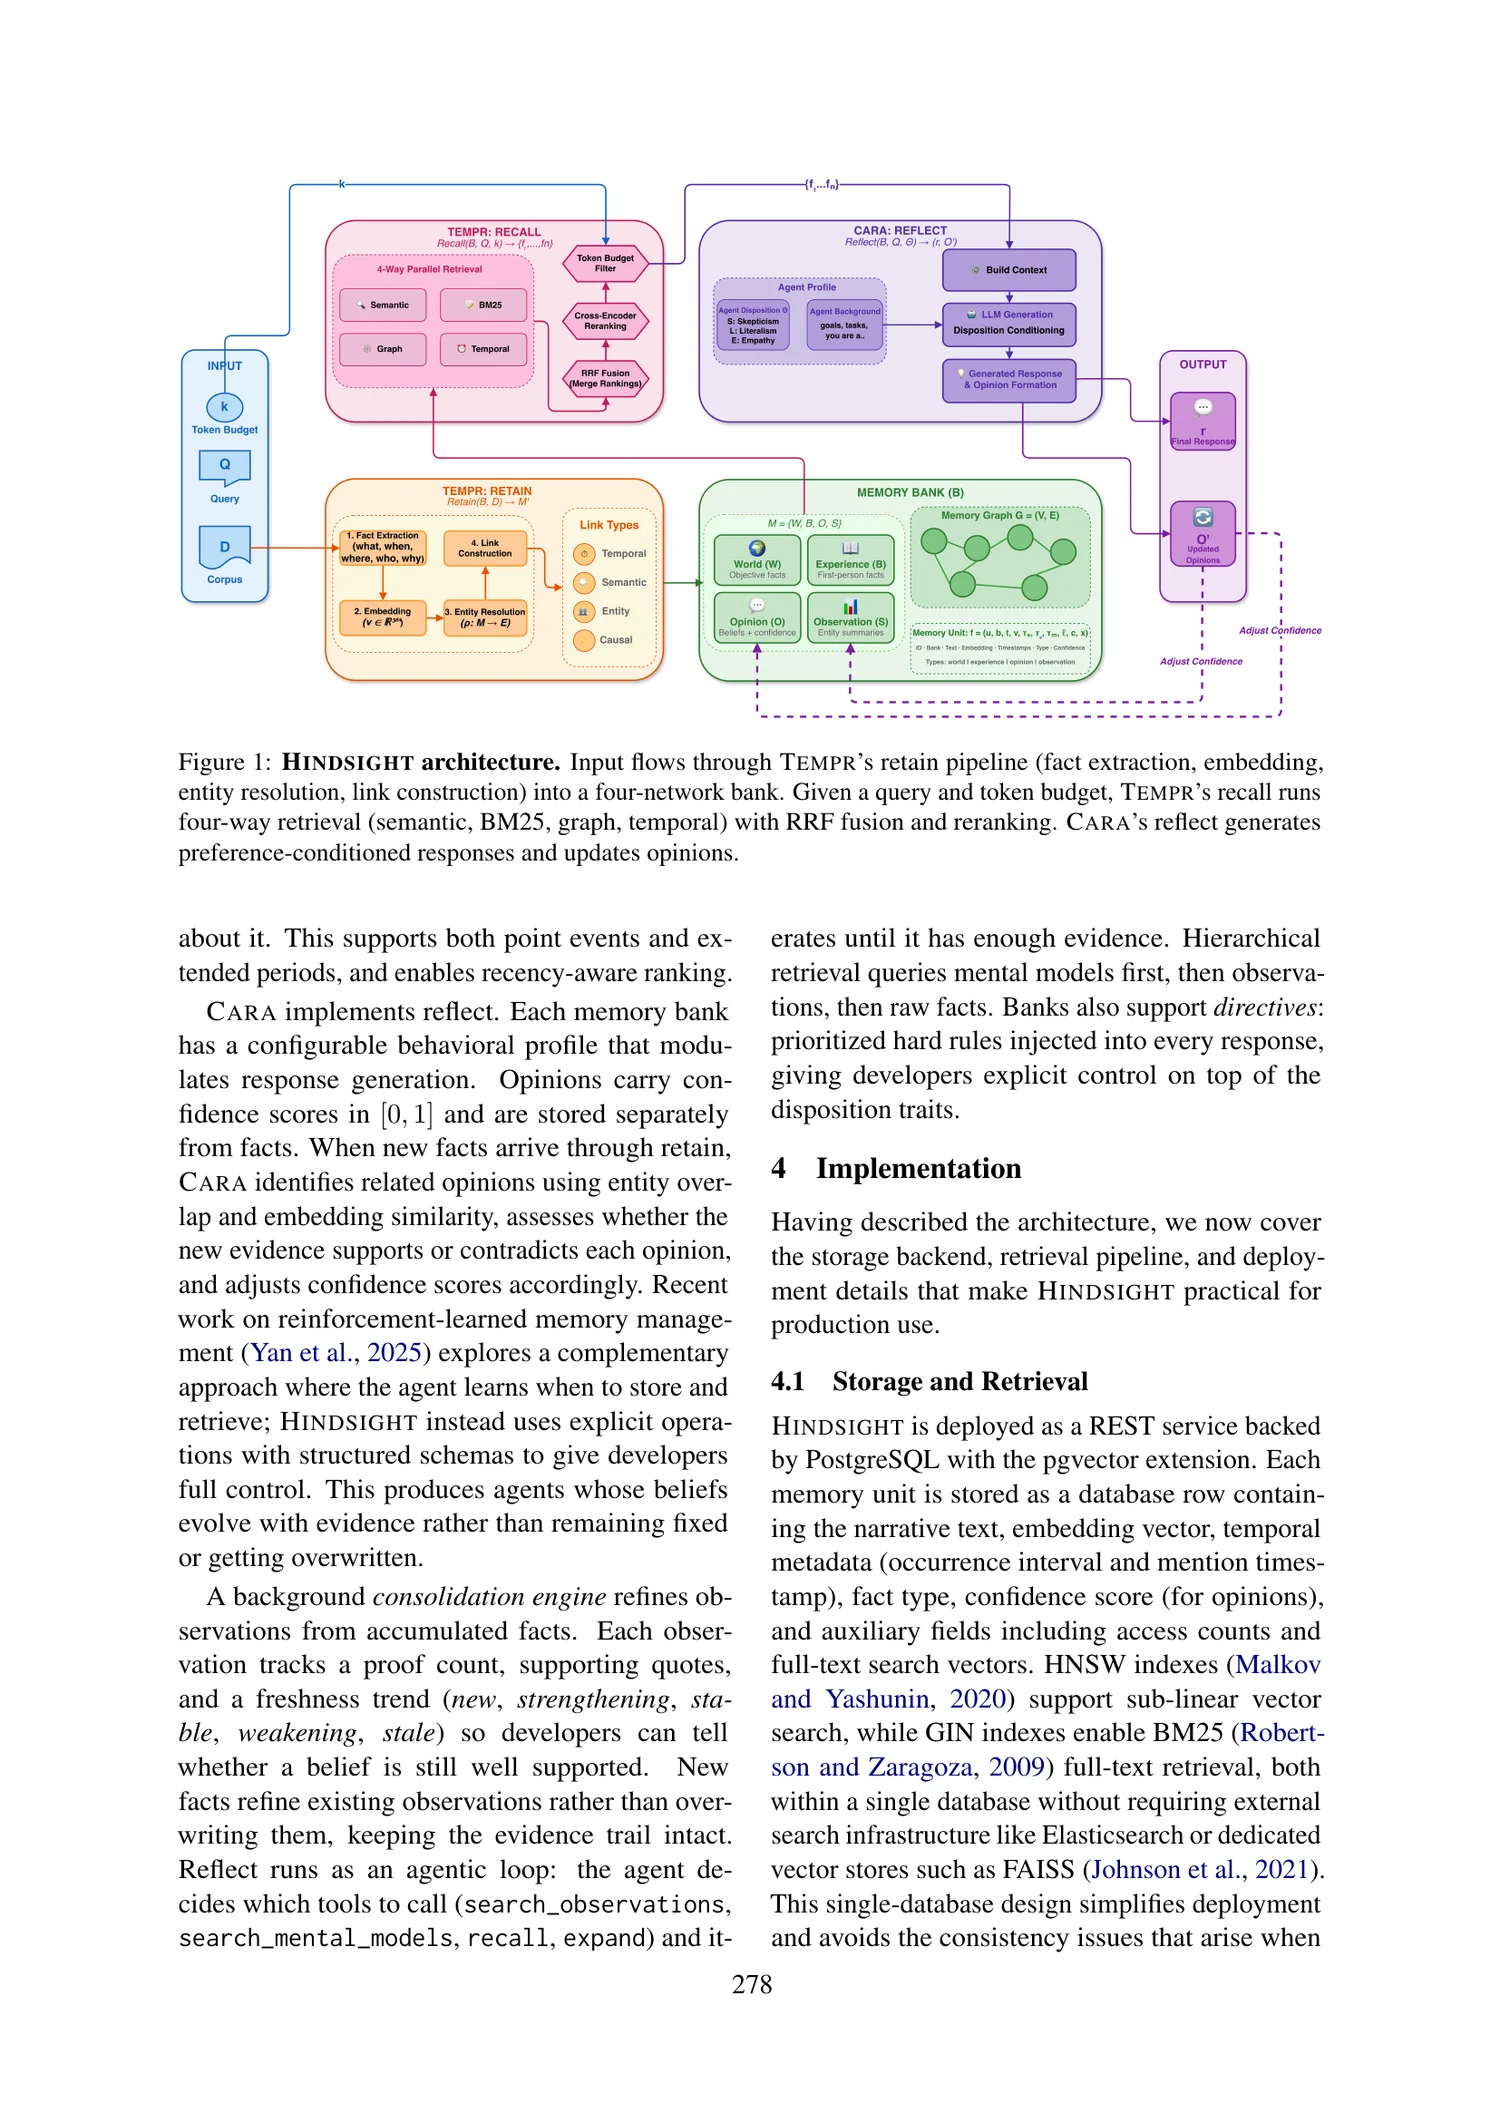
기억에 대한 연산은 세 가지로, 셋은 각자 부르는 별개의 API다. 저장(retain)은 정보를 들여오는 일, 검색(recall)은 꺼내는 일, 추론(reflect)은 그 위에서 답을 빚는 일이다. 대화의 흐름은 시간 인식 기억 층을 거쳐 구조화된 질의 가능한 메모리 뱅크로 쌓이고, 추론은 그 뱅크에서 안에서 찾아 읽은 기억을 바탕으로 답을 짓는다. 이 글은 추론이 답할 때마다 뱅크를 자동으로 되돌아쓴다고 주장하지 않는다.
검색은 벡터 검색, 키워드 매칭, 그래프 탐색, 시간 거르기를 함께 쓰고, 바탕에는 PostgreSQL과 pgvector가 있다. 질의에서 시간 표현과 개체를 먼저 뽑고, 여러 갈래의 검색 결과를 합친 뒤 순서를 다시 매기고, 달라는 예산에 맞춰 순위 매긴 구조화 사실을 돌려준다. 검색은 답을 짓지 않으며, 답을 짓는 일은 추론의 몫이다. 질의 사이에도 상태가 남아 다음에 이어진다는 점이 한 번의 검색으로 끝내는 흐름과의 차이다.
메모리 뱅크는 기억의 이름공간이다. 사용자 하나, 에이전트 하나, 프로젝트 하나가 각자의 뱅크를 갖는다는 비유가 공식 설명이다. 뱅크마다 배경 맥락과 세 기질(회의·직설·공감)의 설명이 실려 있어, 추론이 답을 지을 때 이를 참고한다. 이름공간 분리와 접근 통제는 별개이므로, 격리가 필요하다면 인증·인가 설정을 따로 갖추고 검증해야 한다. 이 글은 뱅크만으로 샐 틈이 없다고 주장하지 않는다.
뱅크 안의 지식은 네 종류가 층을 이룬다. 맨 아래 두 칸은 들여온 세계 사실과 경험 사실이고, 그 위 칸은 관찰이 사실을 묶어 종합한 것이며, 맨 위 칸은 멘탈 모델이 자주 쓰는 지식을 다듬어 둔 것이다. 관찰과 멘탈 모델은 네 종류 안에 든 칸이지, 네 칸 밖에 덧댄 층이 아니다. 추론은 멘탈 모델, 관찰, 날것의 사실 순으로 위칸부터 살핀다. 자주 묻는 것은 다듬어진 답부터, 낯선 것은 밑바탕까지 내려가 살핀다는 정리다.
그림을 글로 읽기
다섯 상자를 잇는 흐름도. 1 앱·에이전트가 대화·문서를 들여오고 질의를 보낸다. 2 저장 retain이 사실을 뽑아 시간 인식 층을 거쳐 메모리 뱅크에 구조화해 쌓는다. 3 메모리 뱅크는 네 기억 종류와 네 갈래 색인을 둔다. 4 검색 recall은 네 갈래를 병렬로 돌려 융합·재순위한 뒤 순위 매긴 구조화 사실을 앱에 바로 돌려준다. 5 추론 reflect는 질의를 받아 뱅크에서 기억을 찾아 읽고 합성한 답을 앱에 돌려준다. recall에서 reflect로 잇는 화살표와 reflect에서 뱅크로 되돌아쓰는 화살표는 없다.
- 질의 풀이
시간 표현과 개체를 먼저 뽑는다
- 네 갈래 병렬 검색
의미·키워드(BM25)·그래프·시간을 함께 돌린다
- 결과 융합
RRF로 여러 갈래를 합친다
- 순서 다시 매기기
교차 인코더로 후보를 가른다
- 토큰 예산 적용
요청한 max_tokens 한도에 맞춰 관련성 순서로 사실을 선택한다
- 구조화 사실 묶음
순위 매긴 사실을 앱에 바로 돌려준다. 답은 짓지 않는다
단계를 글로 읽기
여섯 단계 순서도. 1 질의 풀이: 시간 표현과 개체를 먼저 뽑는다. 2 네 갈래 병렬 검색: 의미·키워드·그래프·시간을 함께 돌린다. 3 결과 융합: RRF로 여러 갈래를 합친다. 4 순서 다시 매기기: 교차 인코더로 후보를 가른다. 5 토큰 예산 적용: 요청한 max_tokens 한도에 맞춰 관련성 순서로 사실을 선택한다. 6 구조화 사실 묶음: 순위 매긴 사실을 앱에 바로 돌려준다. 답은 짓지 않는다.
설치와 서버 실행
아래 절차와 예시는 공식 Quick Start의 흐름을 옮겨 적은 것으로, 마탑 환경에서 직접 실행하지 않은 미실행 예시다. 문서 판 0.10을 2026년 9월 28일에 확인했으며, 버전이 오르면 절차가 바뀔 수 있다. 예시 코드는 공식 저장소의 MIT 허가 공개 패턴을 각색한 것으로, 식별자와 문장은 이 글용으로 바꿨다.
파이썬으로 직접 띄우는 길은 세 단계다. hindsight-api 꾸러미와 hindsight-client 꾸러미를 설치하고, 거대언어모델 키를 환경 변수(HINDSIGHT_API_LLM_API_KEY)로 비공개로 설정한 뒤, hindsight-api 명령으로 서버를 실행한다. 서버가 뜨면 API는 로컬 8888번에서 응답한다. Docker로 같은 환경 변수를 주고 공식 이미지를 실행하는 길과, 서버 없이 쓰는 매니지드 선택지도 문서에 있다. 공통 전제는 구조화 출력을 지원하는 거대언어모델이 필요하다는 점이다.
pip install hindsight-api hindsight-client
export HINDSIGHT_API_LLM_API_KEY="..."  # 실제 키는 비공개로 설정
hindsight-api
# API: http://localhost:8888
최소 사용 예시
서버가 떴다는 전제 아래, 클라이언트는 같은 뱅크 이름으로 세 연산을 각자 부른다. 아래 예시는 탑 읽기 모임이라는 가상의 이름공간에 모임 장소를 저장했다가 찾는 흐름이다. 실행하지 않은 예시이므로 정확한 반환값은 적지 않는다. 저장 단계는 들여온 기록의 확인 정보를, 검색 단계는 질의에 맞는 순위 매긴 기억 후보들을, 추론 단계는 안에서 찾아 읽은 기억들을 바탕으로 지은 답을 돌려주는 역할이다. 검색만 따로 불러 쓸 수도 있고, 검색 결과를 추론에 넘겨 부를 수도 있다.
Node.js·Go·명령줄 클라이언트도 같은 세 연산을 제공한다. 운영으로 가져갈 때는 작업자 식별자를 고정해 재시작해도 같은 일꾼으로 인식되게 하고, 데이터가 담기는 볼륨을 잘 둔다. 외부 PostgreSQL 같은 선택지는 공식 문서를 따른다.
from hindsight_client import Hindsight

client = Hindsight(base_url="http://localhost:8888")
bank = "tower-reading-group"

client.retain(bank_id=bank, content="탑 읽기 모임은 6층 서가에서 열린다.")
found = client.recall(bank_id=bank, query="읽기 모임은 어디에서 열리나?")
answer = client.reflect(bank_id=bank, query="이번 주 모임 장소를 알려줘.")
구체적 따라가기: 연락처가 바뀔 때
이 절부터 세 장면은 모두 가상의 이름과 시간으로 지은, 실행하지 않은 따라가기다. 실제 서버에 보내지 않았으며, 정확한 반환값은 적지 않는다. 입력·질의·기대하는 결과의 종류만 보인다. 식별자와 문장은 이 글용으로 지었으며, 공식 블로그의 이름·시각 표기와 문서 ID·시각 앵커·말머리 사용법을 각색했다.
첫 장면은 단골 고객의 연락처 변경이다. 2026년 3월 2일 오전 9시(UTC) 상담에서 고객 서아가 앞으로는 문자보다 이메일로 연락해 달라고 했다고 하자. 상담 기록을 한 문서로 묶어 들여온다. 문서 ID는 contact-2026-03-02-seoa-01처럼 대화마다 독립적으로 짓고, 시각 앵커에는 상담 시작 시각 2026-03-02T09:00:00Z를, 말머리에는 고객 서아가 상담원과 이야기 중이라는 취지를 적는다. 2026년 4월 15일 오후 2시 30분(UTC) 상담에서 서아가 다시 전화로 연락해 달라고 했다고 하자. 이 대화는 다른 독립 문서 ID contact-2026-04-15-seoa-02로 묶고, 시각 앵커 2026-04-15T14:30:00Z와 같은 말머리를 함께 준다. 같은 문서 ID로 갈아끼우는 다시 들여오기가 아니라, 시각이 다른 두 대화를 따로 쌓는 흐름이다. 이렇게 하면 서아의 1인칭 말이 상담원 자신의 경험이 아니라 서아에 대한 세계 사실로 쌓이는 방향으로 이끌 수 있다는 것이 공식 블로그의 설명이다.
서아의 연락 방법을 물을 때는 시각을 분명히 한다. 검색에 서아 연락 방법 3월 같은 질의를 보내면, 기대하는 결과의 종류는 3월 시각 앵커를 거친 순위 매긴 구조화 사실 후보들이며, 답 문장을 짓는 일은 검색이 아니라 추론의 몫이다. 서아의 현재 연락 방법을 물으면, 기대하는 결과의 종류는 최신 시각 기준의 순위 매긴 구조화 사실 후보들이다. 추론에 같은 질의를 보내면, 안에서 찾아 읽은 기억들을 바탕으로 최신 우선 합성한 답을 돌려주는 역할이다. 어느 단계도 실제 반환값을 단정하지 않으며, 시간 질의가 필요하면 시각 앵커를 빼먹지 않는다는 점만 강조한다.
# 미실행 가상 예시: 실제 서버에 보내지 않음. 반환값은 적지 않음.
client.retain(
    bank_id="support-seoa",
    content=(
        "Seoa (2026-03-02T09:00:00Z): 앞으로는 문자보다 이메일로 연락해 주세요.\n"
        "Agent (2026-03-02T09:01:00Z): 네, 이메일로 연락드리겠습니다."
    ),
    context="Customer Seoa is speaking with the support agent",
    timestamp="2026-03-02T09:00:00Z",
    document_id="contact-2026-03-02-seoa-01",
)
client.retain(
    bank_id="support-seoa",
    content=(
        "Seoa (2026-04-15T14:30:00Z): 앞으로는 전화로 연락해 주세요.\n"
        "Agent (2026-04-15T14:31:00Z): 네, 전화로 연락드리겠습니다."
    ),
    context="Customer Seoa is speaking with the support agent",
    timestamp="2026-04-15T14:30:00Z",
    document_id="contact-2026-04-15-seoa-02",
)
found_march = client.recall(bank_id="support-seoa", query="서아가 3월에 말한 연락 방법은?")
# 기대 종류: 3월 시각 앵커의 순위 매긴 구조화 사실 후보 (답 문장 아님)
found_now = client.recall(bank_id="support-seoa", query="서아의 현재 연락 방법은?")
# 기대 종류: 최신 시각 기준의 순위 매긴 구조화 사실 후보 (답 문장 아님)
answer = client.reflect(bank_id="support-seoa", query="서아에게 어떤 방법으로 연락해야 하나?")
# 기대 종류: 안에서 찾은 기억을 바탕으로 최신 우선 합성한 답- 3월 상담 묶기
3월 2일 대화를 독립 문서 ID 하나로 묶는다
- 4월 변경 묶기
4월 15일 대화를 다른 독립 문서 ID로 묶는다. 같은 ID 갈아끼우기 아님
- 화자·시간 붙이기
이름·시각·timestamp·context를 각 대화에 함께 준다
- 3월·현재 질의
3월과 현재 연락 방법을 각각 묻고 시각별 사실 후보를 받는다
- 합성 답
안에서 찾은 기억을 바탕으로 최신 우선 합성한 답을 돌려준다
단계를 글로 읽기
다섯 단계 순서도. 1 3월 묶기: 2026년 3월 2일 대화를 문서 ID contact-2026-03-02-seoa-01 하나로 묶는다. 2 4월 묶기: 2026년 4월 15일 대화를 다른 문서 ID contact-2026-04-15-seoa-02 하나로 묶는다. 같은 ID 갈아끼우기가 아니다. 3 화자·시간 붙이기: 이름과 ISO 시각을 매 줄마다 적고 각 상담 시작 시각을 timestamp로, 고객 상담 중이라는 context를 함께 준다. 4 3월·현재 질의: 3월에 말한 연락 방법과 현재 연락 방법을 각각 묻고 시각별 순위 매긴 구조화 사실 후보를 받는다. 답은 짓지 않는다. 5 합성 답: 추론이 안에서 찾은 기억을 바탕으로 최신 우선 합성한 답을 돌려준다.
구체적 따라가기: 한 프로젝트를 나누는 기억
둘째 장면은 기획자·조사자·작성자가 한 보고서를 함께 만드는 흐름이다. 세 역할이 같은 프로젝트 뱅크 project-atlas를 바라본다고 하자. 기획자가 마감이 4월 15일이라는 사실을 들여오면, 조사자와 작성자도 같은 뱅크에서 그 사실을 찾을 수 있다. 공식 Strands 가이드는 이를 한 팀의 제도 기억이라고 부르며, 뱅크 ID를 같이 쓰면 기억을 나누고 다르게 쓰면 서로 보이지 않는다고 설명한다. 이 글의 예시는 Strands SDK 호출이 아니라 개념 단계의 갈래 나누기로만 읽는다.
다른 의뢰인의 일은 다른 뱅크에 둔다. 예를 들어 project-atlas와 client-baker-01은 서로 다른 이름공간이라, 한쪽에 쌓은 사실이 다른 쪽 검색에 섞여 나오지 않는 방향이다. 다만 이름공간 분리와 접근 통제는 별개다. 뱅크 ID를 안다고 해서 접근이 통제되는 것이 아니며, 격리가 필요하면 인증·인가·네트워크·키 관리를 따로 갖추고 검증해야 한다. 이 글은 뱅크 ID만으로 샐 틈이 없다고 주장하지 않는다.
읽기와 쓰기를 나누고 싶을 때는 하이브리드가 있다. 공유 뱅크는 읽기로만 참고하고, 각자 메모는 자기 뱅크에 쓰는 방식이다. 공식 가이드는 공유 쪽을 읽기 경로로, 쓰기 쪽을 자기 뱅크 ID의 저장 도구로 나누는 구성을 소개한다. 어느 구성이든, 쓰고 나서 다른 역할이 찾을 수 있는지 직접 확인하는 검증 단계를 빼먹지 않는다는 것이 요지다.
# 미실행 개념 예시: 뱅크 갈래 나누기. 실제 SDK 호출이 아님.
SHARED = "project-atlas"      # 기획·조사·작성이 함께 읽고 쓰는 프로젝트 기억
PLANNER_ONLY = "planner-memo" # 기획자만 쓰는 메모 (다른 역할과 분리)
CLIENT_OTHER = "client-baker-01"  # 다른 의뢰인. project-atlas와 분리

# 기대 종류: 같은 bank_id를 쓰는 역할끼리는 서로의 사실을 찾을 수 있음.
# 기대 종류: 다른 bank_id의 사실은 섞여 나오지 않는 방향.
# 주의: bank_id는 이름공간이지 접근 통제가 아님. 인증·인가는 따로 설계.
구체적 따라가기: 문서를 다시 들여오기
셋째 장면은 문서가 바뀌었을 때다. 공식 Documents API는 같은 문서 ID로 다시 들여오면 옛 내용을 갈아끼운다고 설명한다. 예를 들어 문서 ID tower-report-plan에 보고서 마감 2027년 3월 31일을 들여온 뒤, 같은 ID로 보고서 마감 2027년 4월 15일(연장)을 다시 들여오면, 옛 사실들을 지우고 새 내용에서 다시 뽑는 방향이다. 문서 ID를 안정적으로 두면 다시 들여오기가 멱등해진다는 것이 공식 블로그의 정리다.
실시간으로 자라는 대화에는 덧붙이기 방식이 있다. 전체를 다시 보내지 않고 새로 온 몇 턴만 덧붙이면, 서버가 기존 문서에 이어 붙이고 바뀌지 않은 조각은 다시 뽑지 않는다는 설명이다. 어느 쪽이든, 문서 단위로 원문·기억 수·만든 시각을 조회하거나, 문서째로 지워 딸린 기억을 함께 없애는 관리 API가 있다는 점이 요지다. 삭제는 되돌릴 수 없으니 운영에서는 보관 기간과 함께 설계한다.
이 글의 예시는 개념 단계의 순서로만 읽는다. 입력은 들여오기 내용과 문서 ID, 질의는 지금 계획의 마감이 언제냐는 현재 상태 물음, 기대하는 결과의 종류는 최신 문서에서 뽑힌 사실 후보와 그 합성 답이다. 정확한 반환 필드나 개수는 적지 않으며, 실행 전에는 반드시 최신 공식 문서를 다시 확인한다.
# 미실행 가상 예시: 같은 문서 ID로 갈아끼우기.
client.retain(bank_id="tower-atlas", content="보고서 마감: 2027년 3월 31일", document_id="tower-report-plan")
client.retain(bank_id="tower-atlas", content="보고서 마감: 2027년 4월 15일(연장)", document_id="tower-report-plan")
# 기대 종류: 옛 사실은 지워지고 새 내용에서 뽑힌 사실로 갈아끼움 (실제 반환값은 적지 않음)
이웃 기억 기술과 나란히 보기
Hindsight만 기억을 다루는 것은 아니다. 아래 나란히 보기는 각 공식 문서가 스스로 설명하는 중심을 옮긴 것으로, 우열을 매기지 않는다. 어떤 기술이 부족하다는 식의 단정도 하지 않는다. 읽는 기준은 네 가지다. 기억을 누구 것으로 어떻게 나누는지, 시간을 어떻게 다루는지, 답을 어떻게 조립하는지, 어디에 붙어 어떻게 운영되는지다. 확인일은 2026-09-28이며, 최신을 보증하지 않는다.
Hindsight(문서 0.10 기준)는 뱅크별 네 기억 종류(세계 사실·경험 사실·관찰·멘탈 모델)로 나눈다. 시간은 시각 앵커와 날짜 풀이·범위 거르기로 다루고, 답은 검색이 순위 매긴 구조화 사실을 돌려주면 추론이 합성하는 갈래다. 서버·PostgreSQL·거대언어모델 키를 함께 운영하는 구성이며, 뱅크는 이름공간이다.
Mem0(공식 저장소 문서 기준)는 앱과 모델 사이에 두고 더하기로 사실을 쌓고 찾기로 꺼내는 흐름을 설명한다. 추출·중복 제거·임베딩·개체 연결을 거쳐 SQL·벡터·개체 저장소에 나누어 둔다. 네 신호(의미·키워드·개체·시간)를 함께 보는 융합 검색은 Platform 관리 서비스의 설명이며, 개체 신호는 내장 Graph Memory로 동작한다. OSS 쪽은 구성한 벡터 저장소와 선택적 재순위에 따르며 개체 겹침으로 가중한다고 설명한다. 범위 지정으로 섞임을 막고, 돌려받은 기억 중 무엇을 프롬프트에 넣을지는 앱이 고른다고 설명한다.
Graphiti(Zep 공식 문서 기준)는 시간 지식 그래프를 내세운다. 개체·관계·사실을 삼중항으로 두고, 에피소드 단위로 들여와 valid_at/invalid_at 이중 시간과 간선 생애로 변화를 쫓는다고 설명한다. 공식 Quick Start의 graphiti.search() 예시에서는 의미 유사도와 BM25를 결합해 순위 매긴 사실·관계와 유효 시각을 검색 결과로 돌려준다. 의미·전문 혼합과 그래프 거리 재순위·노드 검색 레시피를 둔다고 하며, 여러 그래프 뒷단과 거대언어모델·임베딩 제공자를 꼽을 수 있다고 한다.
Letta(공식 문서 기준)는 상태를 유지하는 에이전트를 말한다. 기억 블록·메시지·도구가 함께 저장되며, 붙인 기억 블록은 시스템 프롬프트에 들어가고 에이전트가 도구로 기억을 고칠 수 있다고 설명한다. 여러 에이전트가 한 블록을 나누는 공유도 가능하다고 하며, 오래된 메시지도 API·검색 도구로 찾을 수 있다고 한다.
LangGraph(공식 문서 기준)는 단기와 장기를 나눈다. 단기는 스레드별 체크포인터로 여러 턴 대화를 잇고, 장기는 네임스페이스별 저장소에 사용자·앱 단위 자료를 여러 대화 너머로 둔다고 설명한다. 노드에서 저장소를 읽고 쓰는 흐름이며, 실운영에는 데이터베이스 뒷단의 체크포인터·저장소를 쓴다고 한다.
이 글의 정리는 그래서 선택의 문제다. 한 팀의 제도 기억과 시간 질의가 중심이면 Hindsight 쪽 설명이 가깝고, 앱이 고르는 검색 결합이 중심이면 Mem0 쪽, 변화하는 관계의 시점 추적이 중심이면 Graphiti 쪽, 블록·도구로 스스로 고치는 상태가 중심이면 Letta 쪽, 그래프 실행의 스레드·저장소 분리가 중심이면 LangGraph 쪽 설명이 가깝다. 어디에도 이것이 정답이라는 순위는 두지 않으며, 도입 전에는 각 원문을 직접 대조한다.
| 기억 기술(각 공식 문서 기준) | 기억 주체·구조 | 시간 다루기 | 답 조립·연동 |
|---|---|---|---|
| Hindsight(문서 0.10 기준) | 뱅크별 네 종류 세계·경험·관찰·멘탈 | timestamp 앵커·날짜 풀이·범위 거르기 | 검색은 구조화 사실, 추론은 합성 답 |
| Mem0(저장소 문서·Platform/OSS 구분) | add로 사실 추출·user·agent·run 범위 | Platform 시간신호 융합·OSS 구성 따름 | Platform 4신호 융합·OSS 벡터·재순위·앱 선택 |
| Graphiti(Zep 문서 기준) | 시간 지식 그래프·에피소드 | valid_at/invalid_at·간선 생애 | graphiti.search() 순위 사실·관계·유효 시각 |
| Letta(공식 문서 기준) | 기억 블록·메시지 보관·도구 | 블록·메시지 갱신으로 상태 유지 | 블록·도구로 답을 짓고 기억을 고침 |
| LangGraph(공식 문서 기준) | 스레드별 체크포인트·스토어 | 스레드 상태·스토어 검색으로 잇기 | 노드에서 읽고 쓰고 답을 지음 |
표를 글로 읽기
다섯 행 비교표. Hindsight는 뱅크별 네 종류 세계·경험·관찰·멘탈, timestamp 앵커와 날짜 풀이·범위 거르기, 검색은 구조화 사실 추론은 합성 답. Mem0는 add로 사실 추출하고 user·agent·run 범위로 나누며 Platform은 의미·키워드·개체·시간 4신호를 융합하고(Graph Memory 내장) OSS는 구성한 벡터 저장소·선택적 재순위·개체 겹침 가중에 따르며 앱이 골라 프롬프트에 넣음. Graphiti는 시간 지식 그래프와 에피소드 valid_at/invalid_at 간선 생애, 공식 Quick Start의 graphiti.search() 예시에서는 의미 유사도와 BM25를 결합해 순위 매긴 사실·관계와 유효 시각을 검색 결과로 돌려줌. Letta는 기억 블록과 메시지 보관 도구로 스스로 고치며 공유 블록 가능. LangGraph는 스레드별 체크포인트와 네임스페이스 스토어로 단기와 장기를 나누고 노드에서 읽고 씀.
한계와 다음 읽기
한계도 분명히 적는다. 첫째, 기억의 품질은 들여온 사실과 종합 과정의 품질에 묶인다. 엉뚱한 사실을 저장하면 그럴듯한 오답의 재료가 늘어날 뿐이다. 둘째, 사실과 믿음을 나눈다고 해서 믿음이 저절로 옳아지지 않는다. 믿음이 다듬어지는 과정은 관찰되는 흐름이지 정답의 보증이 아니다. 셋째, 문서 판 0.10 기준의 젊은 프로젝트라 인터페이스와 동작이 바뀔 수 있다. 넷째, 기억의 충돌 해소·삭제·보존 기간·개인정보 취급은 도입자가 설계해야 할 운영의 몫이다.
이 글은 벤치마크 수치를 인용하지 않는다. 수치는 모델과 설정에 묶인 스냅샷이며, 이 서가의 판형을 넘는 주장이기 때문이다. 다음 읽기로는 AI의 기억과 컨텍스트, 검색 증강 생성과 검색, 에이전트와 도구 사용 주제 글을 권한다. 기억의 확장사인 발전 과정 글과 함께 읽으면 지형이 보인다.
현재 판 출처 (이 개정의 출처 보관본 아님) 13건
아래는 현재 판의 출처 목록을 고리 풀이용으로 그대로 둔 참조이며, 이 개정의 출처 보관본이 아니다.
- Hindsight: Structured Agent Memory that Retains, Recalls, and Reflects (외부)
S11 - Hindsight is 20/20: Building Agent Memory that Retains, Recalls, and Reflects (외부)
S12 - vectorize-io/hindsight (공식 저장소) (외부)
S13 - Hindsight Documentation (v0.10) (외부)
S14 - Hindsight Quick Start (외부)
S15 - RAG vs Hindsight (공식 비교 페이지) (외부)
S16 - Structuring Chat Logs for Agent Memory (Hindsight Blog) (외부)
S17 - Guide: Per-Agent vs Shared Memory Banks in Strands Agents (외부)
S18 - Hindsight Documents API (외부)
S19 - Mem0: How it works (core concepts) (외부)
S20 - Graphiti Quick Start (Zep docs) (외부)
S21 - Letta: Introduction to Stateful Agents (외부)
S22 - LangGraph: Memory (add-memory) (외부)
S23